... typische Fehler & die Alarmstufen!
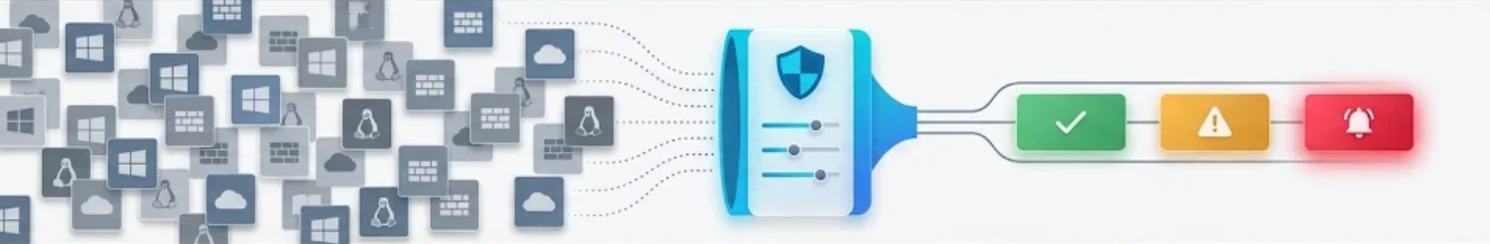
Ein mittelständisches Netz mit Windows- und Linux-Servern, einer Firewall und Microsoft 365 erzeugt jeden Tag mehrere tausend Log-Einträge. Von Hand liest die niemand.
Ein Security Information and Event Management (SIEM) sammelt diese Daten zentral, normalisiert sie und wertet sie nach Regeln aus, damit aus der Masse die wenigen Ereignisse herausfallen, die auf einen Angriff hindeuten.
Wazuh ist dafür eine Open-Source-Plattform, die du ohne Lizenzkosten selbst betreibst. Ein Wazuh, das nach der Installation unverändert weiterläuft, produziert allerdings vor allem Rauschen.
Die meisten Einführungen scheitern an fehlendem Tuning und an Abläufen, die vorher niemand festgelegt hat. Beides lässt sich vor dem Rollout planen.
Wie Wazuh aufgebaut ist
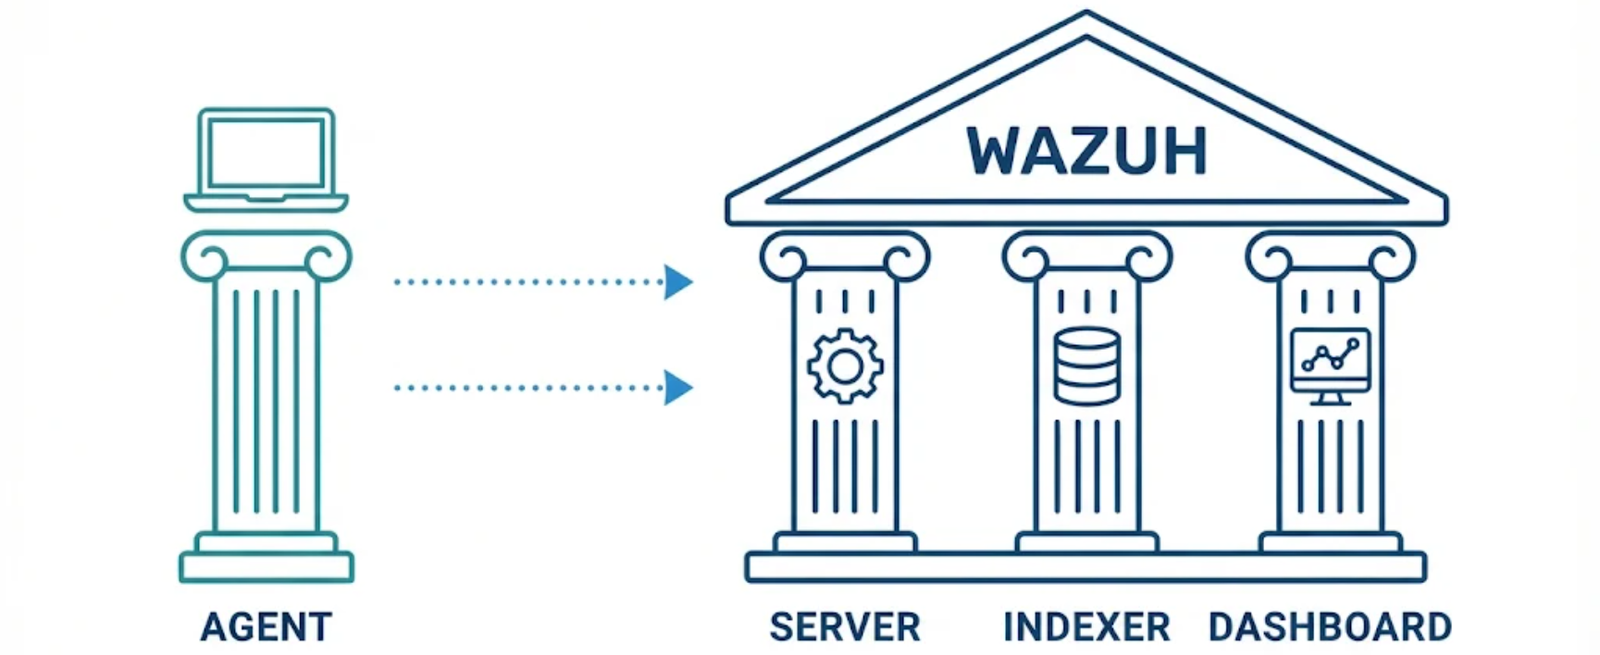
Wazuh besteht aus vier Komponenten. Der Agent läuft auf Windows-, Linux- und macOS-Endpunkten, liest dort Logs, Inventardaten und Dateiänderungen und schickt sie an den Wazuh-Server. Die laufende Verbindung nutzt Port 1514/TCP, die Registrierung neuer Agenten Port 1515/TCP.
Der Server dekodiert die Ereignisse und prüft sie gegen das Regelwerk. Treffer speichert der Wazuh-Indexer, ein Such- und Analysecluster, und das Wazuh-Dashboard macht sie im Browser auswertbar. In der Version 4.x transportiert Filebeat die Alarme vom Server zum Indexer, standardmäßig über Port 9200/TCP mit TLS.
Für Geräte ohne Agent, etwa Firewalls, Switches oder Router, nimmt der Server Syslog entgegen. Der Listener auf Port 514 ist ab Werk deaktiviert, du schaltest ihn in der ossec.conf des Servers ein. Windows-Ereignisprotokolle liest der Agent direkt über den Eventchannel und überwacht dabei standardmäßig die Kanäle System, Application und Security. Weitere Kanäle wie Sysmon oder PowerShell ergänzt du als eigenen <localfile>-Block. Winlogbeat brauchst du dafür nicht.
Microsoft 365 bindet Wazuh über zwei Module an. Das office365-Modul liest die Aktivitäten aus dem Microsoft-365-Tenant, das ms-graph-Modul holt Sicherheitswarnungen und Incidents aus Microsoft Defender sowie Intune-Audit-Ereignisse über die Graph API. Willst du zusätzlich Entra-Anmeldeprotokolle per Graph API abrufen, setzt Microsoft dafür eine Lizenz für Entra ID P1 oder P2 im Tenant voraus.
Wazuh 5.0 liegt als Release Candidate vor und hat noch keinen GA-Termin. Die neue Hauptversion baut die Architektur um: Filebeat entfällt, der Server schreibt direkt in den Indexer, und erste Tests aus der Community zeigen, dass eigene Regeln aus 4.x angepasst werden müssen.
Für eine Einführung heißt das: Starte auf 4.14 und plane den Umstieg auf 5.0 als eigenes Projekt, sobald die Version allgemein verfügbar ist.
weitere wazuh Funktionen
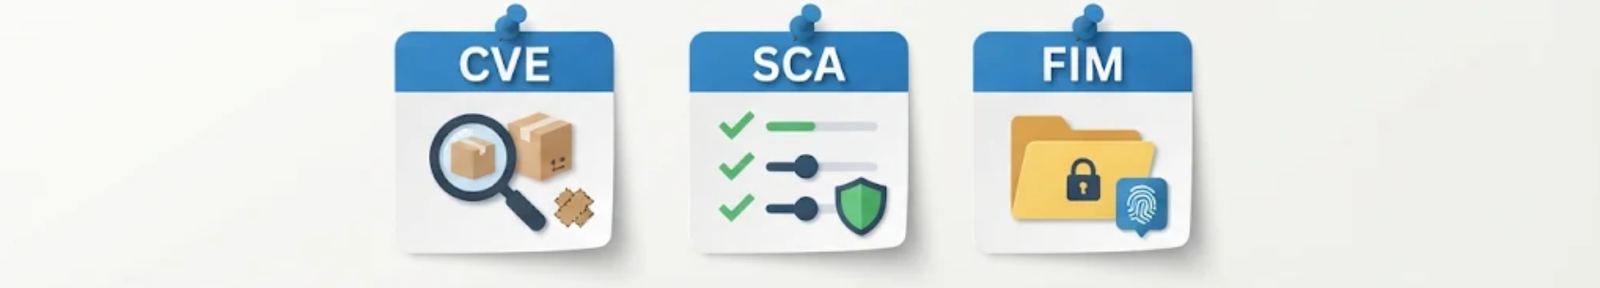
Agenten konfigurierst du zentral über Agentengruppen. Eine neue Logquelle oder ein zusätzlicher Überwachungspfad landet damit auf allen Hosts der Gruppe, ohne dass du jeden Server einzeln anfasst. Drei Module liefern Informationen, die über klassisches Log-Management hinausgehen.
Schwachstellenerkennung
Der Agent inventarisiert über das Syscollector-Modul Betriebssystem und installierte Pakete. Der Server gleicht diese Liste mit der Wazuh Cyber Threat Intelligence (CTI) ab. Die CTI bündelt Daten von Herstellern wie Microsoft, Red Hat, Ubuntu und Debian sowie aus NVD, OSV und dem CISA-Katalog.
Liegt eine installierte Version im betroffenen Bereich einer CVE, erzeugt Wazuh einen Befund. Unter Windows prüft Wazuh zusätzlich, ob ein installierter Hotfix die Lücke bereits schließt. Ein gepatchtes System taucht so nach dem Patchday nicht weiter als verwundbar auf.
Security Configuration Assessment
Das SCA-Modul prüft die Konfiguration der Endpunkte gegen hinterlegte Richtlinien, die überwiegend auf den CIS-Benchmarks aufbauen. Ein noch aktiviertes SMBv1 oder ein abgeschaltetes Audit-Logging fällt so auf, bevor ein Angreifer es ausnutzt. Weil sich eine Fehlkonfiguration ohne jede Lücke im Code ausnutzen lässt, lohnt es sich, die SCA-Ergebnisse regelmäßig abzuarbeiten statt nur den Prozentwert im Dashboard zu beobachten.
File Integrity Monitoring
FIM überwacht festgelegte Dateien und Verzeichnisse und meldet jede Änderung. Ein Angreifer verändert nach dem Einbruch typischerweise Binärdateien, Autostart-Einträge oder Konfigurationen. Ein FIM-Alarm auf einem Server, an dem gerade niemand arbeitet, ist deshalb ein frühes Signal. Mit aktiviertem Whodata enthält der Alarm zusätzlich den Benutzer und den Prozess, der die Änderung vorgenommen hat.
Dimensionierung und Skalierung
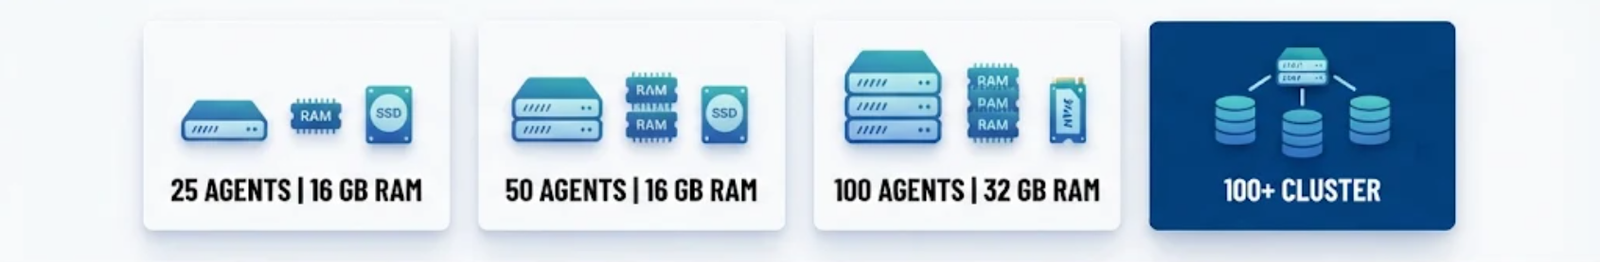
Übersicht nach Agentenzahl (90 Tage Vorhaltezeit)
| Agenten | Bereitstellung | Server-Nodes (vCPU, RAM) | Indexer-Nodes (vCPU, RAM) | NVMe-Speicher gesamt |
| 1 bis 25 | All-in-One, 1 Host | 4 vCPU, 16 GiB (kombiniert) | auf dem Server-Host | 100 GB |
| 26 bis 50 | All-in-One, 1 Host | 8 vCPU, 16 GiB (kombiniert) | auf dem Server-Host | 150 bis 200 GB |
| 51 bis 100 | All-in-One, 1 Host | 8 vCPU, 24 bis 32 GiB (kombiniert) | auf dem Server-Host | 250 bis 300 GB |
| 101 bis 250 | kleines Cluster | 2 × (8 vCPU, 8 GiB) | 3 × (8 vCPU, 16 GiB) | 600 GB bis 1 TB |
| 251 bis 500 | mittleres Cluster | 2 × (8 vCPU, 16 GiB) | 3 × (8 vCPU, 32 GiB) | 1,2 bis 2 TB |
| 501 bis 1.000 | großes Cluster | 3 × (8 bis 16 vCPU, 16 GiB) | 3 bis 5 × (16 vCPU, 32 bis 64 GiB) | 2,5 bis 5 TB |
| 1.001 bis 2.500 | Enterprise-Cluster | 4 × (16 vCPU, 16 GiB) | 5 bis 7 × (16 vCPU, 64 GiB) | 6 bis 12 TB |
Der Speicherbedarf hängt an Ereignisrate und Aufbewahrungsdauer. Musst du Alarme 180 statt 90 Tage vorhalten, rechne grob mit dem doppelten Platz. Die Werte sind Richtgrößen für den Start. Nach einigen Wochen Betrieb siehst du im Dashboard die echte Ereignisrate pro Sekunde und kannst nachsteuern.
Rollen in einem verteilten Cluster
Wie sich ein Cluster für 100 bis 500 Agenten nach Maschinenrollen zusammensetzt, zeigt diese Aufteilung:
| Rolle | Knoten | vCPU pro Node | RAM pro Node | Disk pro Node |
| Wazuh-Server (Master) | 1 | 8 | 8 bis 16 GiB | 50 bis 100 GB SSD |
| Wazuh-Server (Worker) | 1 bis 3 | 8 | 8 GiB | 50 bis 100 GB SSD |
| Wazuh-Indexer (Data und Cluster-Manager) | mindestens 3 | 8 bis 16 | 16 bis 32 GiB | 300 bis 800 GB NVMe |
| Wazuh-Dashboard | 1, oder auf dem Master | 4 | 4 bis 8 GiB | 30 GB SSD |
| Load Balancer (NGINX oder HAProxy) | 1 bis 2 | 2 | 2 bis 4 GiB | 20 GB SSD |
Warum der Indexer mindestens drei Knoten braucht
Der Wazuh-Indexer basiert auf OpenSearch. Jede Entscheidung im Cluster, etwa die Wahl des Cluster-Managers, braucht eine Mehrheit der stimmberechtigten Knoten. Bei zwei Knoten sind das beide. Fällt einer aus, gibt es keine Mehrheit mehr, und der verbliebene Knoten nimmt keine Schreibzugriffe an.
Ein Split-Brain verhindert OpenSearch zwar über genau diese Mehrheitsregel, die Ausfallsicherheit ist mit zwei Knoten aber trotzdem weg. Erst ab drei Knoten bleibt nach einem Ausfall eine Mehrheit von zwei übrig. Gleichzeitig kann der Cluster dann jeden Primary-Shard mit einem Replica auf einem anderen Knoten absichern.
Die 31-GiB-Grenze beim JVM-Heap
Den Heap des Indexers legst du in /etc/wazuh-indexer/jvm.options fest. Wazuh empfiehlt dafür die Hälfte des Arbeitsspeichers, bei 32 GiB RAM also:
-Xms16g
-Xmx16g
Setze den Heap trotzdem nie über 31 GiB, auch wenn der Host 64 GiB RAM hat. Oberhalb von etwa 32 GiB schaltet Java die Compressed Ordinary Object Pointers (Compressed OOPs) ab. Jeder Objektzeiger belegt dann 8 statt 4 Byte, der Heap fasst bei gleicher Größe weniger Daten, und die Garbage Collection wird teurer.
Die zweite Hälfte des RAMs bleibt bewusst frei: Der Linux-Kernel nutzt sie als Dateisystem-Cache für die Lucene-Segmente, und davon profitieren die Suchen im Dashboard direkt. Damit das Betriebssystem den Heap nicht auslagert, setzt du zusätzlich bootstrap.memory_lock: true in der opensearch.yml.
Load Balancer vor den Server-Knoten
Ab zwei Wazuh-Server-Knoten sollen sich die Agenten gleichmäßig verteilen und beim Ausfall eines Knotens automatisch umziehen. Dafür setzt du einen Netzwerk-Load-Balancer wie NGINX oder HAProxy vor die Server. Er verteilt die Ereignisverbindungen auf Port 1514/TCP auf die Worker. Die Agenten-Registrierung auf Port 1515/TCP leitet er an den Master, alternativ zeigen die Agenten dafür direkt auf den Master.
Die Server-Knoten selbst stimmen sich über Port 1516/TCP ab: Der Master verteilt darüber Agent-Keys, Agentengruppen, eigene Regeln und Decoder, SCA-Richtlinien und CDB-Listen an die Worker. Fällt ein Worker aus, laufen dessen Agenten über den Load Balancer auf die verbliebenen Knoten, und die Auswertung geht weiter.
Die Alarmstufen richtig lesen
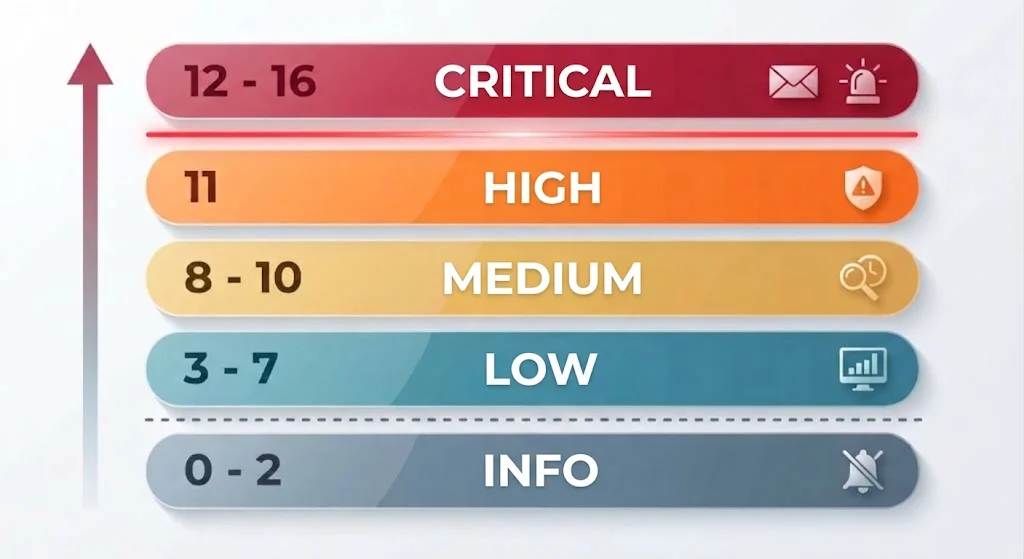
Wazuh ordnet jede Regel einem Level von 0 bis 16 zu.
Das Level beschreibt, wie sicherheitsrelevant ein einzelnes Ereignis ist, und entscheidet damit über Speicherung und Benachrichtigung.
Die offizielle Klassifizierung sieht so aus:
| Level | Bedeutung laut Wazuh | Beispiel |
| ignoriert | Regel unterdrückt bekannte Fehlalarme | |
| 1 bis 2 | geringe Relevanz, Systemmeldungen | Statusmeldungen ohne Sicherheitsbezug |
| 3 | erfolgreiche oder autorisierte Ereignisse | erfolgreiche Anmeldung, erlaubte Firewall-Verbindung |
| 4 | Systemfehler niedriger Priorität | Fehlkonfiguration, ungenutztes Gerät |
| 5 | vom Benutzer verursachter Fehler | falsches Passwort, verweigerte Aktion |
| 6 | geringe Angriffsrelevanz | Virus ohne Wirkung, häufige IDS-Ereignisse |
| 7 | Treffer auf Schlüsselwörter | Meldung enthält „bad“ oder „error“ |
| 8 | erstmals beobachtet | erste Anmeldung eines Benutzers, erster IDS-Alarm |
| 9 | Fehler aus ungültiger Quelle | Anmeldeversuch unbekannter Benutzer, Fehler am Admin- oder root-Konto |
| 10 | mehrere Benutzerfehler | wiederholt falsche Passwörter |
| 11 | Warnung der Integritätsprüfung | veränderte Binärdateien, Rootkit-Fund |
| 12 | Ereignis hoher Wichtigkeit | Fehler und Warnungen von System oder Kernel |
| 13 | ungewöhnlicher Fehler hoher Wichtigkeit | entspricht einem gängigen Angriffsmuster |
| 14 | Sicherheitsereignis hoher Wichtigkeit | meist durch Korrelation ausgelöst |
| 15 | schwerer Angriff | Fehlalarm nahezu ausgeschlossen |
| 16 | maximale Schwere | von keiner Standardregel genutzt, für eigene Regeln reserviert |
Zwei Schwellwerte in der ossec.conf bestimmen, was mit diesen Leveln passiert. log_alert_level steht standardmäßig auf 3, alles darunter erzeugt keinen Alarm. Die E-Mail-Schwelle email_alert_level setzt die mitgelieferte Manager-Konfiguration auf 12, die Referenzdokumentation nennt als Standardwert dagegen 7. Prüfe den Wert in deiner Installation, bevor du dich auf Mails verlässt.
Für den Eskalationsweg liefert das Level nur die Grundlage, die Grenzen ziehst du selbst. Als Ausgangspunkt eignet sich dieses Schema: Alarme bis Level 7 wertest du im Dashboard für Trends aus. Level 8 bis 10 sichtest du täglich, weil dort neue Anmeldungen und Brute-Force-Muster auftauchen. Level 11 prüfst du am selben Tag, da veränderte Binärdateien auf eine erfolgreiche Kompromittierung hindeuten können.
Ab Level 12 geht eine Benachrichtigung an die Bereitschaft, und Level 14 bis 16 lösen deinen Incident-Response-Ablauf aus. Passe die Grenzen an, sobald du nach einigen Wochen Betrieb siehst, wie viele Alarme auf jedes Level fallen.
Typische Fehler bei der Einführung
Kein Ziel und keine Use Cases
„Wir brauchen ein SIEM, weil die Compliance es verlangt“ ist kein Projektziel. Leg vor der Installation fest, welche Angriffe du erkennen willst: Brute Force gegen das VPN, Anmeldungen aus Ländern, in denen niemand aus deinem Unternehmen arbeitet, Änderungen an der Gruppe der Domänen-Admins. Aus diesen Use Cases ergeben sich die nötigen Datenquellen und Regeln.
Wer umgekehrt erst alle Logs sammelt und dann überlegt, was er damit anfängt, füllt Speicher und produziert Alarme, die niemand einordnen kann.
Kläre im selben Schritt, ob Cloud-Dienste, Active Directory oder Linux-Server dein größtes Risiko sind. Davon hängt ab, welche Systeme du zuerst anbindest und wie viel Hardware du in den ersten Monaten brauchst.
Zu wenig Zeit für den Betrieb
Ein SIEM ist kein Produkt, das du einmal einrichtest. Jemand muss Alarme lesen, einordnen und bei Bedarf eskalieren, und genau dieser Aufwand fehlt in vielen Projektplänen. Plane nach der Einführung feste Zeit für das Tuning der Regeln, die Pflege der Datenquellen und die Auswertung ein. Ohne diese Zeit veraltet das Regelwerk, und das Team gewöhnt sich daran, Alarme wegzuklicken.
Lücken bei den Datenquellen
Ein SIEM erkennt nur, was es sieht. Fehlt das Log eines kritischen Systems, bleibt genau dort ein blinder Fleck. Im Idealfall bindest du diese Quellen an:
- Netzwerkgeräte wie Firewalls, Switches und Router
- Server und Clients unter Windows, Linux und macOS
- Cloud-Dienste wie Microsoft 365, Azure, AWS und Google Cloud
- Sicherheitskomponenten wie IDS/IPS, Virenschutz und Endpoint Detection and Response
- Anwendungs-Logs von Datenbanken, Webservern und ERP-Systemen
Endpunkte schicken ihre Daten über den Agenten, Netzwerkgeräte per Syslog an den Server. Liefert eine Anwendung ein Logformat, das Wazuh nicht kennt, schreibst du einen eigenen Decoder. Ohne Decoder landen die Zeilen zwar im System, die Regeln können aber keine Felder wie Benutzer oder Quell-IP auswerten, und damit fällt die Korrelation aus.
Standardregeln ohne Tuning
Das Standardregelwerk von Wazuh ist ein Startpunkt, kennt aber deine Umgebung nicht. Wer sie unverändert laufen lässt, erzeugt entweder eine Flut von Fehlalarmen oder übersieht Ereignisse, die nur in seinem Netz kritisch sind. Die Folge ist Alarmmüdigkeit: Das Team ignoriert Warnungen, weil die meisten davon nichts bedeuten, und echte Angriffe gehen in der Masse unter.
Drei Stellschrauben helfen dagegen. Über Schwellwerte legst du fest, ab wie vielen fehlgeschlagenen Anmeldungen in welchem Zeitfenster ein Alarm entsteht. Ausnahmen setzt du als Kindregel mit Level 0, etwa für Testsysteme oder Labornetze, in denen hohes Alarmaufkommen normal ist. Korrelationsregeln fassen mehrere ähnliche Ereignisse aus verschiedenen Quellen zusammen und heben ihre Relevanz. Eigene Regeln legst du in /var/ossec/etc/rules/local_rules.xml mit IDs ab 100000 an, damit ein Update des Standardregelwerks sie nicht überschreibt.
Arbeitet dein Unternehmen viel remote, verdienen VPN-Anmeldungen und Cloud-Zugriffe eigene Regeln. In anderen Umgebungen sind Buchungen außerhalb der Geschäftszeiten das kritische Muster. In beiden Fällen trennst du damit Fehlalarme von echten Bedrohungen.
Fehlende Schulung
Ein Alarm nützt nur, wenn jemand ihn versteht. Wer mit Wazuh arbeitet, braucht Grundlagen in vier Bereichen: Log-Analyse, um bösartige Muster zu erkennen, Alarmkorrelation, um Zusammenhänge zwischen Ereignissen zu sehen, Forensik, um Systeme im Verdachtsfall zu untersuchen und Beweise zu sichern, und Angriffstechniken, um neue Muster einordnen zu können.
Für den letzten Punkt hilft das MITRE-ATT&CK-Framework, denn Wazuh ordnet viele Regeln bereits ATT&CK-Techniken zu. Weil sich Angriffsmethoden laufend ändern, gehört Weiterbildung in den festen Jahresplan.
Veraltete Versionen und Regeln
Wazuh veröffentlicht in der 4.14-Reihe 2026 etwa monatlich Patch-Releases: 4.14.6 am 1. Juli, 4.14.7 am 29. Juli, 4.14.8 am 23. September, 4.14.9 am 14. Oktober und 4.14.10 am 5. November. Version 4.14.8 hat unter anderem die Pfadvalidierung und die Anmeldelimits der Server-API gehärtet. Wer solche Updates monatelang liegen lässt, betreibt ein Sicherheitswerkzeug mit bekannten Schwächen.
Neben der Software pflegst du eigene Indikatoren für Kompromittierungen (Indicators of Compromise, IoCs). Wazuh nimmt sie als CDB-Listen auf, etwa mit bekannten bösartigen IP-Adressen oder Datei-Hashes, und gleicht eingehende Ereignisse dagegen ab.
Kein Incident-Response-Ablauf
Ein SIEM liefert Alarme, aber keine Reaktion. Damit aus einem kritischen Alarm eine Gegenmaßnahme wird, brauchst du vorher Antworten auf drei Fragen. Wer analysiert den Alarm, und wer gibt Gegenmaßnahmen frei? Welche Schritte folgen, etwa ein forensisches Abbild oder die sofortige Isolation des Systems? Über welchen Kanal informiert ihr euch, wenn das eigene Netz kompromittiert ist?
Wazuh kann einfache Reaktionen selbst ausführen. Active Response blockiert zum Beispiel eine angreifende IP-Adresse auf dem betroffenen Host, sobald eine bestimmte Regel auslöst. Für komplexere Abläufe bindest du eine SOAR-Plattform (Security Orchestration, Automation and Response) an. Shuffle ist als Integration bereits mitgeliefert.
Keine Dokumentation
Mit der Zeit sammelt jede Wazuh-Installation eigene Regeln, Decoder, Ausnahmen und neue Datenquellen an. Fehlt die Dokumentation dazu, dauert die Fehlersuche länger, und das Wissen hängt an einer Person. Leg deshalb Regeln, Decoder und Konfiguration in ein Git-Repository. Jede Änderung bekommt so einen Zeitstempel und eine Begründung, und ein neues Teammitglied sieht nachvollziehbar, warum eine Regel so aussieht, wie sie aussieht.
weitere Punkte ...
Compliance nur behauptet
Wazuh liefert Zuordnungen seiner Regeln zu PCI DSS, DSGVO (GDPR), HIPAA, NIST 800-53 und den Trust Services Criteria (TSC) mit, inklusive passender Dashboards. Die Dokumentation stellt klar, dass diese Zuordnungen ein Richtwert sind und keine formale Zertifizierung ersetzen. Für ISO 27001 oder NIS2 gibt es keine fertige Zuordnung. Du kannst aber eigene Compliance-Kennungen in deine Regeln eintragen und darüber filtern.
Für Unternehmen in Deutschland ist das seit dem 6. Dezember 2025 relevant: An diesem Tag ist das NIS2-Umsetzungsgesetz in Kraft getreten. § 30 Abs. 2 BSIG verlangt von betroffenen Einrichtungen unter anderem Maßnahmen zur Bewältigung von Sicherheitsvorfällen und zur Bewertung der Wirksamkeit ihres Risikomanagements. Ein SIEM liefert für beides Nachweise, ersetzt aber kein Informationssicherheits-Managementsystem.
Denk dabei an den Datenschutz. Logs enthalten Benutzernamen und IP-Adressen und damit personenbezogene Daten. Leg deshalb Aufbewahrungsfristen fest und setze sie im Indexer über Richtlinien zur automatischen Löschung um, statt Alarmdaten unbegrenzt zu speichern.
Anbindung an Drittsysteme
Der Integrator-Dienst von Wazuh bringt fertige Anbindungen an Slack, PagerDuty, VirusTotal, Shuffle und Maltiverse mit. Weitere Ziele, etwa ein Ticketsystem oder einen Teams-Kanal, bindest du über ein eigenes Skript an, dessen Name mit custom- beginnt. So entsteht bei einem kritischen Alarm automatisch ein Ticket, und die Nachverfolgung hängt nicht davon ab, dass jemand gerade ins Dashboard schaut.
Die VirusTotal-Integration prüft die Hashes von Dateien, die FIM als neu oder verändert meldet, gegen die VirusTotal-Datenbank. Zusammen mit den CDB-Listen und Maltiverse ergänzt sie die eigenen Regeln um externe Bedrohungsdaten.
Community & Support
Fragen zu Wazuh beantwortet die Community im Slack-Workspace, auf der Mailingliste bei Google Groups, auf Reddit, Discord und in den GitHub-Diskussionen. Dort findest du auch die Antworten der Entwickler zu Release-Plänen, etwa zum Stand von Wazuh 5.0. Wer eine verbindliche Reaktionszeit braucht, kauft bei Wazuh professionellen Support, Beratung oder Schulungen. Mit Wazuh Cloud gibt es außerdem eine gehostete Variante, bei der du dich nicht selbst um Server und Indexer kümmerst.
Was sich wirtschaftlich rechnet
Wazuh kostet keine Lizenz, aber Hardware und Arbeitszeit. Der Gegenwert entsteht, wenn ein Angriff früh genug auffällt, um ihn einzudämmen, bevor er Produktion oder Verwaltung lahmlegt. Dazu kommen die Nachweise für Audits, die du sonst mühsam aus einzelnen Systemen zusammensuchst, und eine Entlastung des Teams, weil automatische Korrelation die manuelle Log-Suche ersetzt.
Fazit
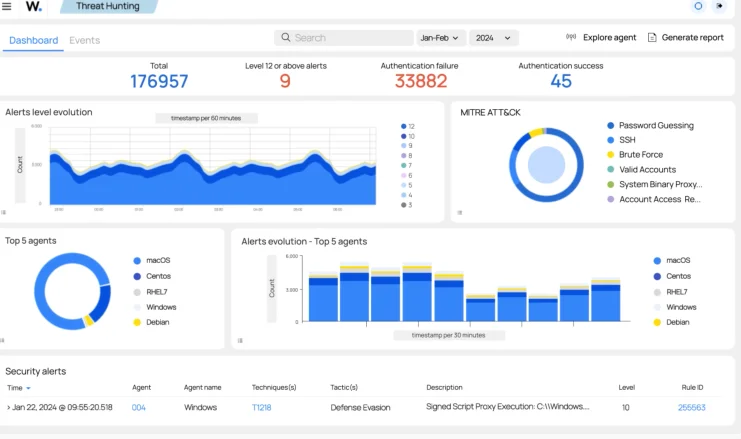
Wazuh ist für Unternehmen ohne eigenes Security Operations Center eine ernsthafte Option, sofern jemand feste Zeit für Tuning und Auswertung bekommt.
Starte mit wenigen klar definierten Use Cases, lies die Alarmstufen nach der offiziellen Klassifizierung, schreibe eigene Regeln mit Ausnahmen und Schwellwerten, und leg den Eskalationsweg fest, bevor der erste Level-12-Alarm eintrifft.
Setze heute auf Version 4.xx und plane den Wechsel auf 5.0 erst, wenn die Version allgemein verfügbar ist und du deine eigenen Regeln dagegen getestet hast.
💬 Kommentare
0 KommentareSei der Erste und starte die Diskussion mit einem hilfreichen Beitrag.
Kommentar hinterlassen
Dein Beitrag wird vor der Veröffentlichung kurz geprüft — fachlich, respektvoll und auf den Punkt ist hier genau richtig.